
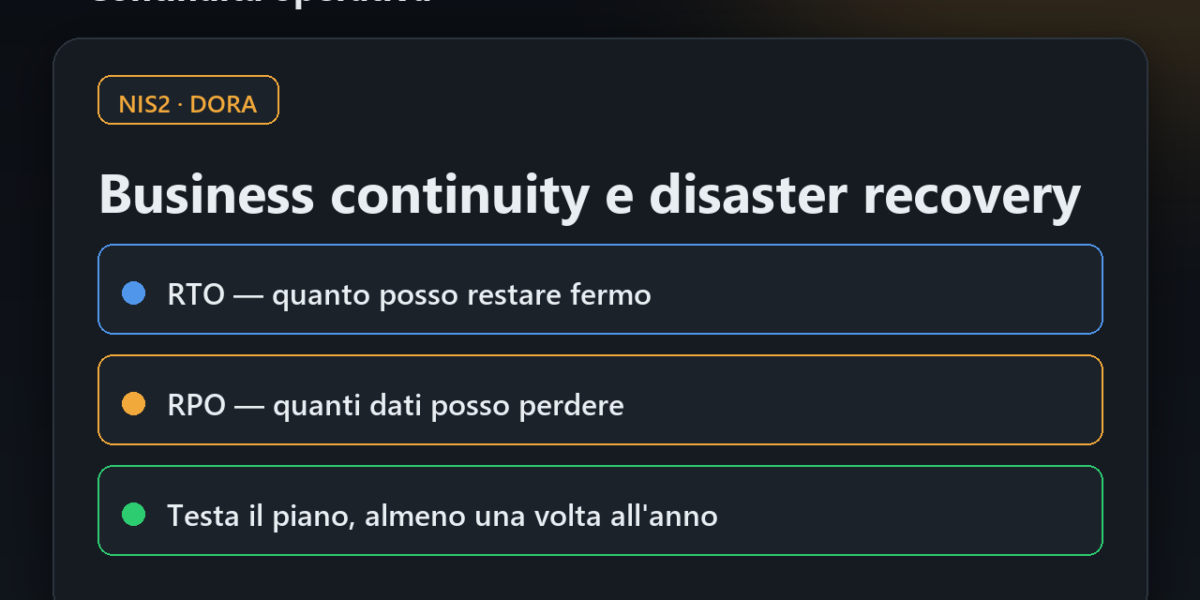
Quando si parla di continuità operativa, l’errore più diffuso è confondere il documento con la capacità. Avere un piano scritto non significa saperlo eseguire sotto pressione. NIS2 e DORA partono proprio da qui: chiedono procedure testate, non solo redatte. In questo articolo raccolgo cosa deve contenere un piano di business continuity (BC) e disaster recovery (DR), da dove iniziare concretamente e come definire gli obiettivi di ripristino senza copiarli da un template.
Cosa chiede la norma, in modo esatto
La direttiva NIS2 elenca, tra le misure minime di gestione del rischio, la continuità operativa, e la definisce come “gestione del backup e ripristino in caso di disastro, e gestione delle crisi” (art. 21, paragrafo 2, lettera c). È una richiesta secca: backup, disaster recovery, gestione della crisi. Tre pilastri, non uno.
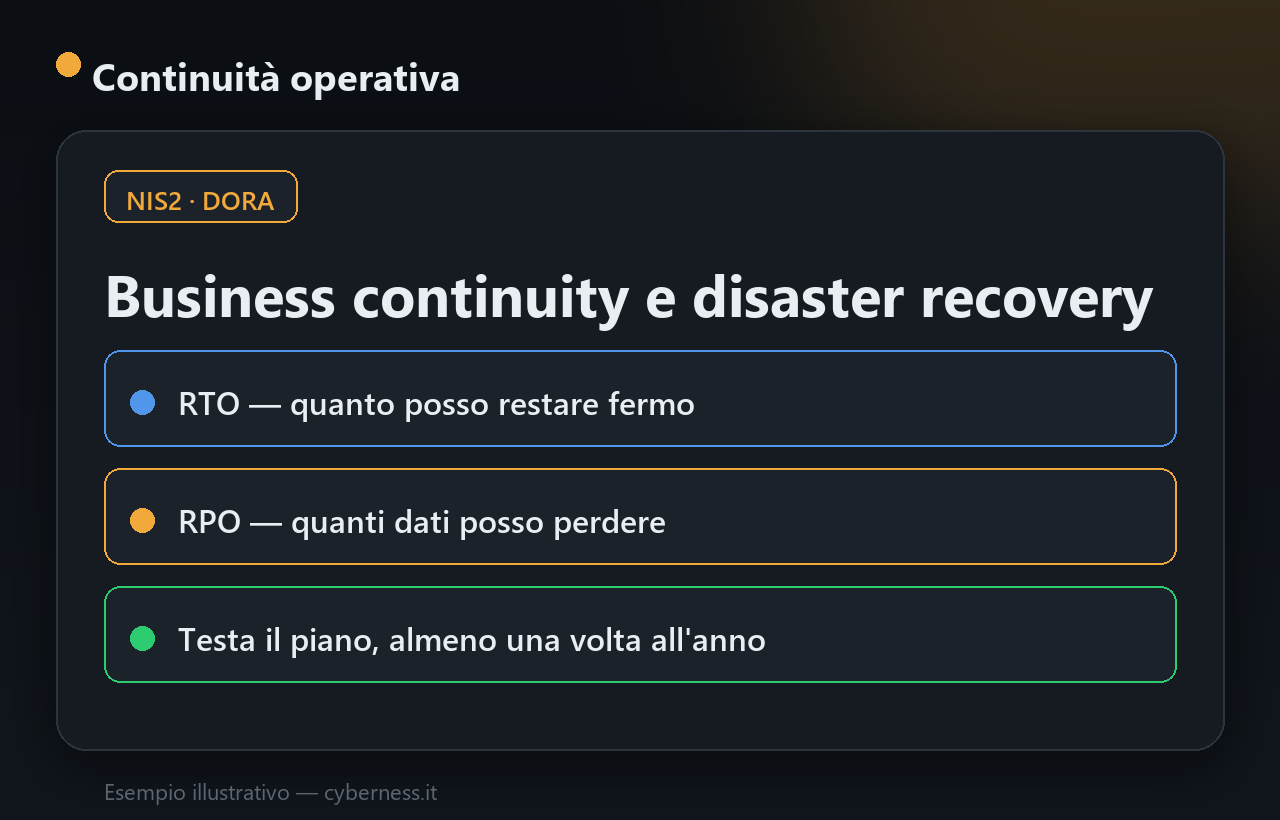
DORA, per il settore finanziario, è più dettagliata. L’art. 11 impone una politica di continuità operativa delle TIC integrata nella continuità aziendale complessiva, con piani di risposta e ripristino documentati che limitino i danni e diano priorità alla ripresa delle funzioni critiche. Il paragrafo 6 dello stesso articolo fissa un obbligo che vale la pena scolpire: i piani di continuità e i piani di risposta e ripristino vanno testati almeno una volta all’anno, e comunque dopo modifiche sostanziali ai sistemi critici. L’art. 12 aggiunge le regole sui backup: l’ambito e la frequenza minima dei backup vanno stabiliti “in base alla criticità delle informazioni o al livello di riservatezza dei dati”, i sistemi di ripristino devono essere fisicamente e logicamente separati dal sistema di origine, e le procedure di backup e ripristino vanno sottoposte a test periodici.
Anche chi non ricade sotto DORA può usarne l’impianto: NIS2 chiede la stessa sostanza, DORA la rende operativa.
RTO e RPO: i due numeri che tengono in piedi il piano
Un piano di DR senza obiettivi misurabili è un tema di scuola. I due parametri da fissare per ogni processo o sistema critico sono:
- RTO (Recovery Time Objective): il tempo massimo entro cui un servizio deve tornare operativo dopo l’interruzione. Risponde alla domanda “quanto posso restare fermo?”.
- RPO (Recovery Point Objective): la quantità massima di dati che posso permettermi di perdere, misurata nel tempo. Risponde alla domanda “a quale momento passato posso tornare?”. Un RPO di un’ora significa backup almeno orari.
Questi valori non si inventano: derivano da una Business Impact Analysis (BIA). Per ogni processo si stima l’impatto dell’interruzione nel tempo (economico, operativo, reputazionale, sanzionatorio) e si ricava quanto è sostenibile stare fermi e quanti dati si possono perdere. Il RPO detta la frequenza dei backup; il RTO detta l’architettura di ripristino. Sono i requisiti, non l’infrastruttura, a guidare la spesa.
Cosa deve contenere il piano, sezione per sezione
Un piano utilizzabile in emergenza ha una struttura minima ricorrente:
- Ambito e funzioni critiche: quali servizi copre il piano, con RTO e RPO per ciascuno. Senza questa mappa il resto è aria.
- Ruoli e catena di attivazione: chi dichiara lo stato di crisi, chi coordina, chi esegue il ripristino, chi comunica. Nomi e sostituti, non solo funzioni.
- Trigger e scenari: gli eventi che attivano il piano (guasto data center, ransomware, indisponibilità fornitore, perdita di sede).
- Procedure di backup: cosa, con quale frequenza, dove, con quale ritenzione. Almeno una copia segregata fisicamente e logicamente, protetta da modifiche e cancellazioni (regola d’oro: la copia che sopravvive a un ransomware è quella che l’attaccante non può raggiungere).
- Procedure di ripristino: i passi tecnici per riportare in servizio, con l’ordine corretto delle dipendenze. Un servizio non riparte se prima non riparte il database e l’autenticazione.
- Comunicazione e crisi: chi informa direzione, autorità competente, clienti; con quali canali alternativi se la posta è ferma.
- Piano di test e registro delle prove: calendario, esiti, azioni correttive.
Da dove partire davvero
Chi inizia da zero non deve scrivere il documento perfetto al primo colpo. L’ordine che restituisce risultati è questo:
- Inventario dei servizi critici. Non si protegge ciò che non si conosce. Prima l’elenco dei processi che, se fermi, fanno male.
- BIA leggera. Per ciascun servizio, una stima di impatto nel tempo. Anche una tabella a tre colonne (1 ora / 1 giorno / 1 settimana) è un punto di partenza serio.
- RTO e RPO assegnati, coerenti con la BIA e discussi con chi gestisce il business, non decisi in solitudine dall’IT.
- Verifica dei backup esistenti. Domanda scomoda ma decisiva: l’ultimo restore è stato provato? Un backup mai ripristinato è un’ipotesi, non una garanzia.
- Un test, anche piccolo. Un ripristino reale di un sistema secondario vale più di trenta pagine. È l’unica cosa che trasforma il piano in capacità.
La differenza tra un piano che supera un audit e uno che salva davvero l’azienda sta tutta nell’ultimo punto: il test. NIS2 lo implica, DORA lo scrive nero su bianco con cadenza annuale. Conviene adottare quel ritmo a prescindere dal perimetro normativo, perché è l’unico modo per scoprire i buchi quando non costano nulla, e non nel giorno dell’incidente.